Může AI poznat osobnost z textu? Jen pokud jsme velmi opatrní
Může AI poznat osobnost z textu? Jen pokud jsme velmi opatrní
Modely, které odhadují osobnostní styl z textu, mohou vypadat přesvědčivě. Jenže dobré skóre často nestačí. Je nutné hlídat úniky v datech, kalibraci a skutečnou užitečnost adaptace.
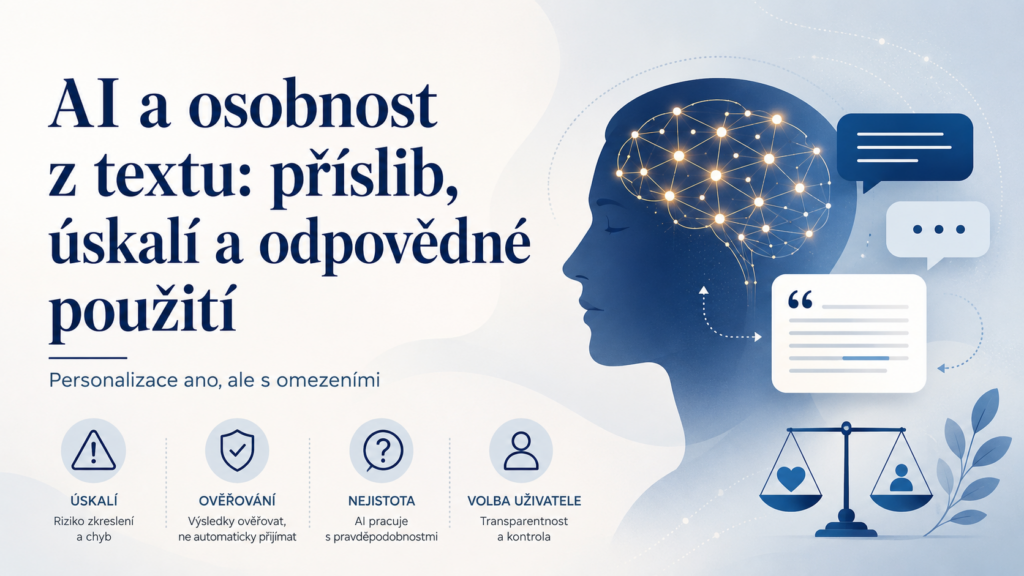
Myšlenka, že AI dokáže z textu poznat osobnost uživatele, je atraktivní. Mohla by pomoci přizpůsobit komunikaci, doporučení nebo styl podpory. Zároveň je to oblast, kde je snadné sklouznout k přehnaným tvrzením.
Dobré skóre klasifikátoru ještě nestačí
V našem výzkumu proto k odhadům osobnostního stylu přistupujeme opatrně. Neptáme se jen, zda klasifikátor dosáhne dobrého skóre. Ptáme se také:
- zda je dosažené skóre skutečně důvěryhodné,
- zda nevzniklo kvůli únikům informací v datech,
- zda model rozumně vyjadřuje svou nejistotu,
- zda je jeho výstup dostatečně užitečný pro konkrétní způsob adaptace systému.
Samotná přesnost proto není dostatečným důkazem, že model zachytil něco psychologicky nebo prakticky významného.
Když se model naučí nápovědu místo osobnosti
Ve veřejných datových sadách pro predikci osobnostních typů se často vyskytuje problém data leakage. Model se může naučit nikoli osobnostní styl, ale slova, zkratky, komunitní fráze nebo přímé odkazy na samotné typy.
Výsledek potom vypadá dobře v tabulce metrik, ale nemusí znamenat, že model zachytil něco skutečně použitelného. Proto je nutné data čistit, odstraňovat zjevné typové výrazy a testovat, jak moc výkon klesne, když se odstraní snadné nápovědy.
Nejistota je stejně důležitá jako správná odpověď
Druhou otázkou je kalibrace. Model může nejen chybovat, ale také být příliš jistý ve špatné odpovědi. To je pro adaptační systémy podstatné.
Jiný problém je, když AI nabídne nepřesné doporučení u volitelného příkladu, a jiný, když podle nejistého osobnostního odhadu změní způsob důležité expertní rady. V některých situacích může být bezpečnější neadaptovat vůbec nebo se uživatele přímo zeptat na preferovaný styl komunikace.
Omezená adaptační hypotéza
Proto pracujeme s pojmem omezená adaptační hypotéza. Textem odhadnutý styl by neměl být chápán jako psychometrická pravda o člověku. Může jít pouze o opatrný signál, který systém použije tehdy, když:
- prošel validačními kontrolami,
- má dostatečnou míru jistoty,
- adaptace je nízkoriziková,
- uživatel může přizpůsobení změnit nebo odmítnout.
Tento přístup je důležitý pro znalostní expertní systémy (knowledge-based expert systems), doporučovací systémy i AI podporu obecně. Personalizace může být užitečná, ale nesmí být slepá.
Nestačí říci, že model něco predikuje. Je třeba doložit, že predikce je dostatečně robustní, přiměřeně jistá a v daném použití skutečně přináší hodnotu oproti jednodušším alternativám.
Možná je lepší se jednoduše zeptat
Velmi často se zapomíná právě na realistické alternativy. Možná není potřeba osobnost odhadovat z textu, pokud se lze uživatele jednoduše zeptat, zda chce:
- stručnou odpověď,
- detailní vysvětlení,
- postup krok za krokem.
V mnoha systémech může být explicitní volba bezpečnější, transparentnější a spolehlivější než skrytá inference.
Praktický závěr
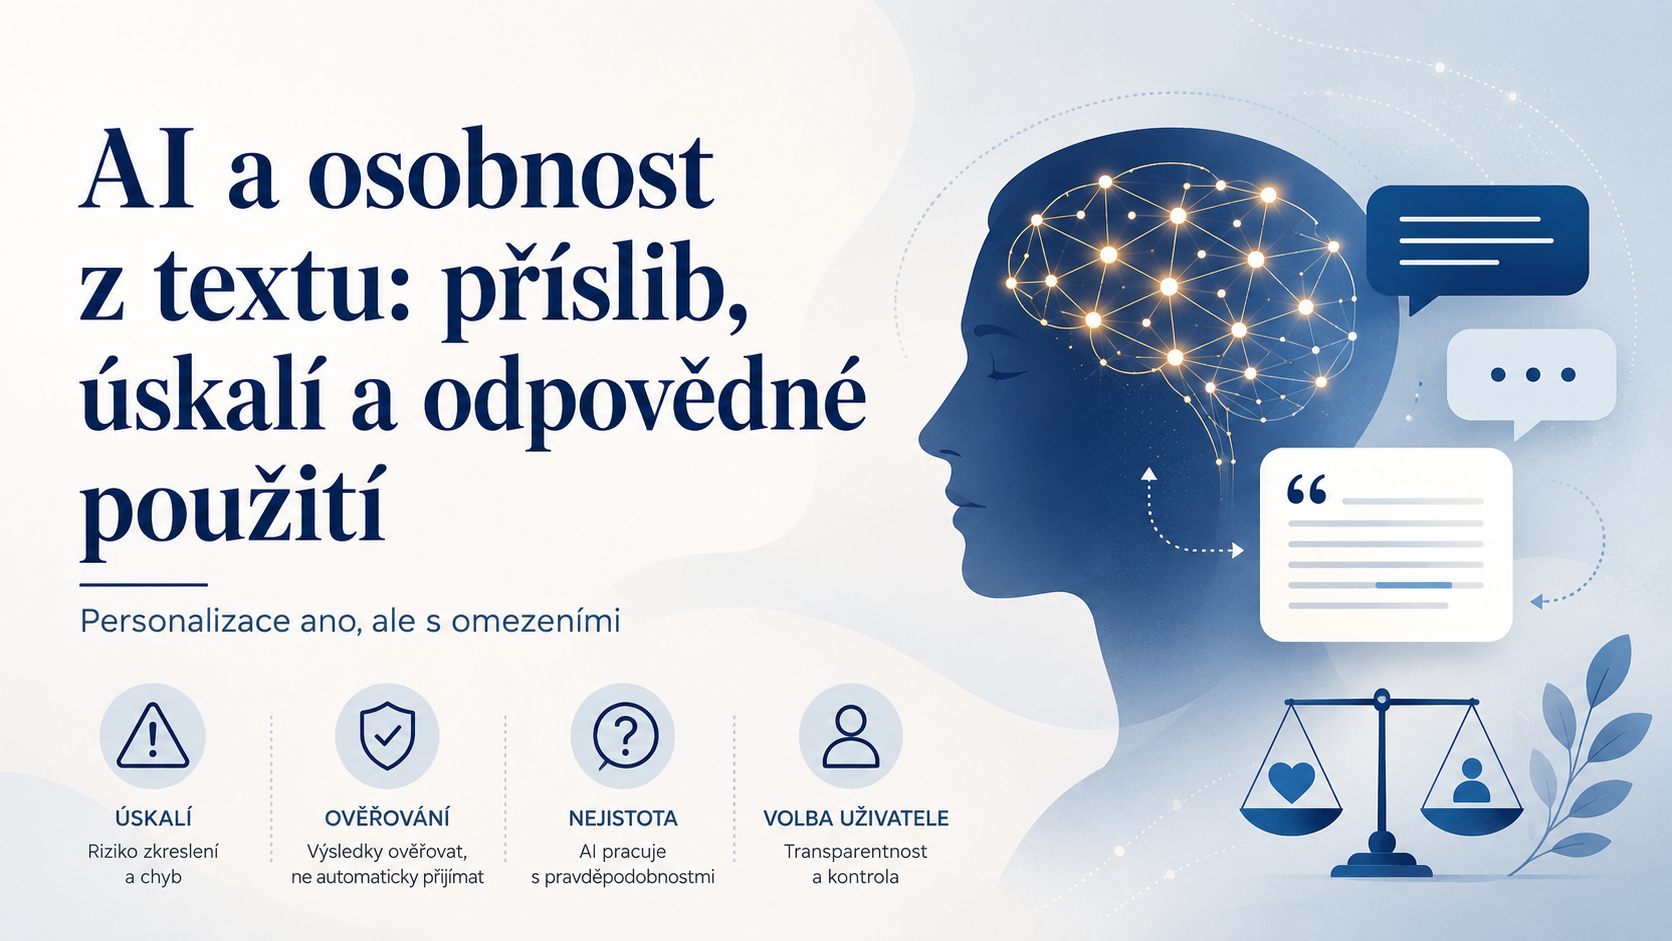
Personalizace ano, ale s omezeními
Výzkum osobnostních signálů z textu není jen technická úloha klasifikace. Je to otázka validity, etiky, užitečnosti a řízení rizika.
AI může pomoci přizpůsobit podporu člověku, ale pouze tehdy, když víme, co model skutečně umí, kde jsou jeho limity a kdy je lepší jej nepoužít.